凌晨三点 CI 里跑完的那条 prompt,输出格式全对、退出码 0,字段名却拼错了一个字母,下游读到的是空列。OpenAI 的 Charlie Guo 在 AIEWF 2026 上管这叫「魔法咒语已死」:一次性 prompt 有三个窟窿,早期成功掩盖脆弱、没有完成判据、没法当流程资产。文中给出一套五步改造法,以及哪些 prompt 可以先不动的判断清单。
你调了三周的那条 prompt 不是资产,是负债
凌晨三点 CI 里跑完的那条 prompt,输出格式全对、退出码 0,字段名却拼错了一个字母,下游读到的是空列。OpenAI 的 Charlie Guo 在 AIEWF 2026 上管这叫「魔法咒语已死」:一次性 prompt 有三个窟窿,早期成功掩盖脆弱、没有完成判据、没法当流程资产。文中给出一套五步改造法,以及哪些 prompt 可以先不动的判断清单。
806 个仓库的对照研究显示,采用 AI 编码工具后环复杂度平均涨了 25.1%;6.23 亿次真实提交的分析里,代码重复涨 81%、跨文件函数调用掉 35%。Agent 偏爱加法不是能力问题,是上下文、训练信号和沙箱三者叠加出的最优策略。这篇拆它为什么会这样,以及 AGENTS.md、PostToolUse 闸门、重构 profile 和定时巡检测出来的四个漏子。
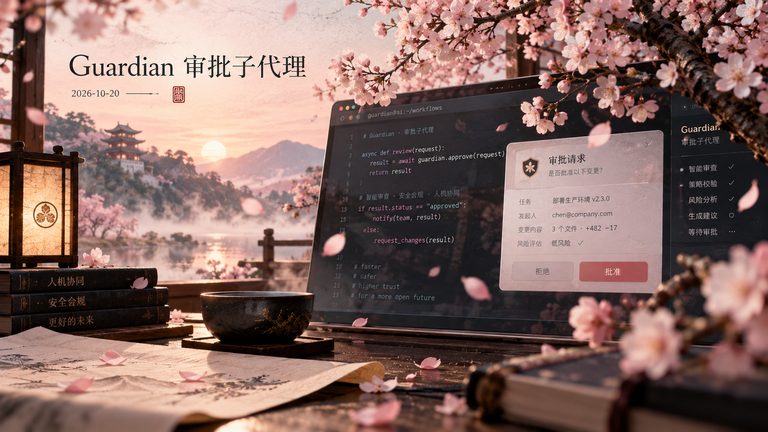
Agent 跑长任务最大的瓶颈不是模型能力,是它每越界一步都要你按一次确认,而你不可能一直在线。Guardian 子代理就是来解决这件事的:它跑在只读沙箱里,输出 0 到 100 的风险分,低于 80 就自动放行。这篇文章拆它的判定维度、源码里的真实常数、v0.160.0 补的上下文,以及启用之前你必须想清楚的三个问题。
三个月,两个订阅,一群 agent,把一款射击游戏反编译回 C++。第一个月进度飞快,代码却是错的。问题不在模型,在于没人定义过什么叫正确。作者的解法是字节比对:一个只回 PASS 或 FAIL 的脚本,外加一套防止 agent 自己改判分的办法。

苏黎世联邦理工把 AGENTS.md 拿去做了一次对照实验:138 个真实 issue,四套 agent,三种设置。自动生成的那份让成本涨了 20%,成功率没动。人写的版本好一点,但差得也不多。问题出在哪一节,以及该怎么删。